

廉价模型浪潮让成本纪律更难,而非更易
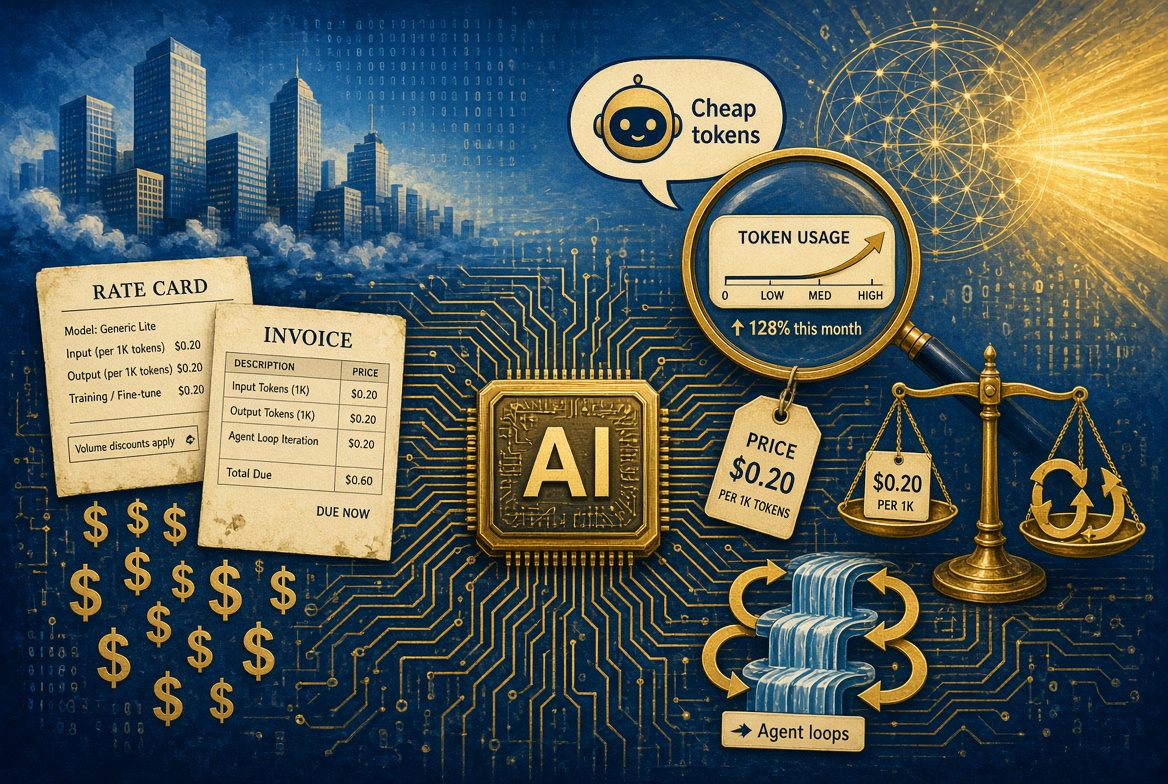
过去两周半里,主力模型的单价又一次发生了变动。7月30日,OpenAI 将 GPT-5.6 Luna 的价格下调80%,降至每百万输入 Token 0.20美元、每百万输出 Token 1.20美元,并将 Terra 的价格下调20%,降至2美元和12美元。旗舰模型 GPT-5.6 Sol 的价格维持在5美元和30美元不变。8月10日,Anthropic 将 Claude Sonnet 5 每百万 Token 2美元/10美元的入门优惠价格永久化,并取消了原定于9月1日生效、上调至3美元/15美元的计划。8月13日,Google 推出 Gemini 3.7 Flash,提供每百万 Token 0.75美元/3.75美元的入门价,有效期至2026年12月31日,是 3.6 Flash 发布价的一半,该价格将于2027年1月1日翻倍。
财务团队会把这些数字读作一种宽慰。但他们更应该把它们读作一个警示。更便宜的 Token,只会招来更多循环调用、更多被路由的草稿,以及更多缺乏监督的智能体——而账单往往并没有因此多出一个新的负责人。
当标价下降而用量不受限制时,企业省下的并不是钱,而是失去了最后一个去追问“这次调用究竟该不该发生”的理由。
这轮降价真正改变了什么
这些降价是真实的,而且集中在业务量最大的环节。如今,Luna 的价格已经便宜到足以支撑分类、信息提取、初稿撰写以及智能体的第一步调用。Sonnet 5 被锁定为一款主力模型,而不再是一个财务部门必须按“9月冲击”来建模的促销价格。Gemini 3.7 Flash 的定价,目的是在今年剩余时间里,把编码和智能体流量吸引到 Google 的技术栈上。Google 还把 3.6 Flash 调整为同样的入门价,因此目前两款模型的价格相同,所谓的头条式折扣,实际上是一个有截止日期的窗口期。
但这一切都没有改变四个运营层面的事实。
第一,智能体工作会让 Token 用量成倍增长。一条用户指令,可以扩散成多次工具调用、重试、规划步骤和冗长的推理轨迹。在 Gemini 3.7 Flash 上,输出计费包含了思维 Token,因此推理时间越长的模型,即便给出的是同一个答案,收费也会更高。如果同一个工作流现在要运行十次,那么廉价模型上80%的降价,并不会转化为整个工作流80%的成本下降。
第二,订阅席位和 API 计量是两个独立的预算。OpenAI 在下调 Luna 和 Terra 消耗的额度的同时,并未改变 ChatGPT 和 Codex 的订阅价格与配额。一家企业可能会觉得订阅席位内“变宽裕了”,却在来自 API 的账单、编码工具的超额费用,或转售同一批模型的供应商账单上,感到“变拮据了”。
第三,入门价终究是一项产品决策。Google 已经公布了 3.7 Flash 在2027年1月的涨价计划;而 Anthropic 则刚刚证明,一项已公布的涨价计划同样可以被撤销。无论哪种情况,价目表都是供应商的选择,而非你所能掌控的变量,用它来做预测并不可靠。
第四,Token 本身就是一个变动的计量单位。Sonnet 5 及其后续 Claude 模型采用了更新的分词器,对同一段文本,产生的 Token 数量比 Sonnet 4.6 多出约30%。一个从每百万 Token 3美元/15美元的 Sonnet 4.6,转向2美元/10美元的 Sonnet 5 的团队,实际节省的金额会比头条数字所暗示的要少,因为计价器如今在每一页文本上计出的单位更多了。
为什么更便宜的模型反而加剧了治理难题
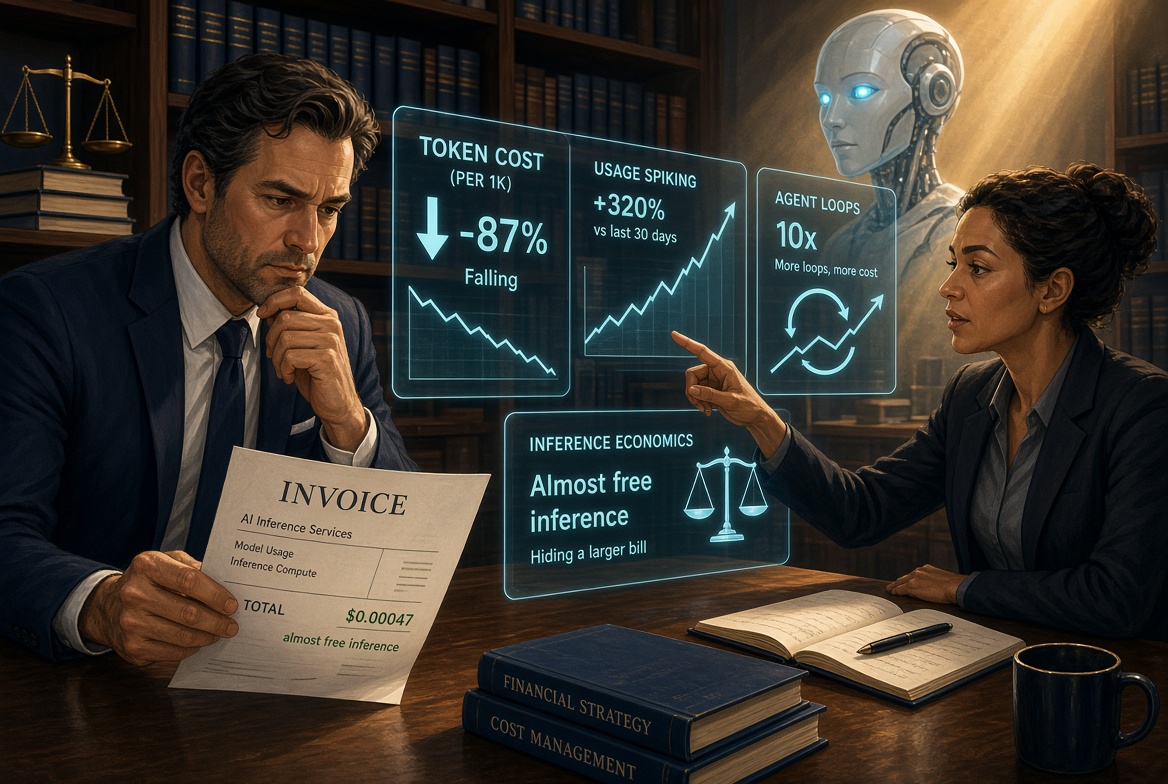
大多数公司衡量人工智能成本的方式,仍然停留在衡量试点项目的阶段:Token 数量乘以标价,或者席位数量乘以供应商报价。而一旦员工可以选择更便宜的模型、却不必选择更简单的任务,这种衡量方法就会立刻失效。
这种失败模式并不陌生。某团队因为单位成本看起来很低,就把摘要生成和工单撰写工作迁移到 Luna 或 Flash 上;随后,智能体开始不断重试失败的工具调用;开发者让编码智能体整夜运行。一家中型市场企业发现,“几乎免费”的推理,竟然成了云支出中增长最快的一个新科目,而且没有人能说清楚,这笔费用究竟是哪个流程产生的。
还有一种质量与成本之间的置换,永远不会出现在价目表上。一个需要三次人工修改、两次额外检索,或需要在前沿模型上再跑一遍的廉价模型,最终反而是昂贵的;而一个能够一次性完成任务的中端模型,可能才是更便宜的选择。如果没有路由规则、没有评估机制、也没有指定的负责人,企业买到的会是低标价,付出的却是高总价。
同样的落差,也出现在与供应商的对话中。供应商如今可以说,这款模型比上个月便宜了80%,却对重试次数、上下文窗口的浪费、未被缓存的提示词,以及触发下游系统的写入操作只字不提。价格是供应商乐于谈论的那部分,而对用量的掌控,则是买家必须自己承担的那部分。
如果企业内所有获批使用的模型明天全部降价50%,谁能阻止某个智能体在一个周末之内,就把省下来的钱全部花光?
“每美元智能”这种虚假的安慰
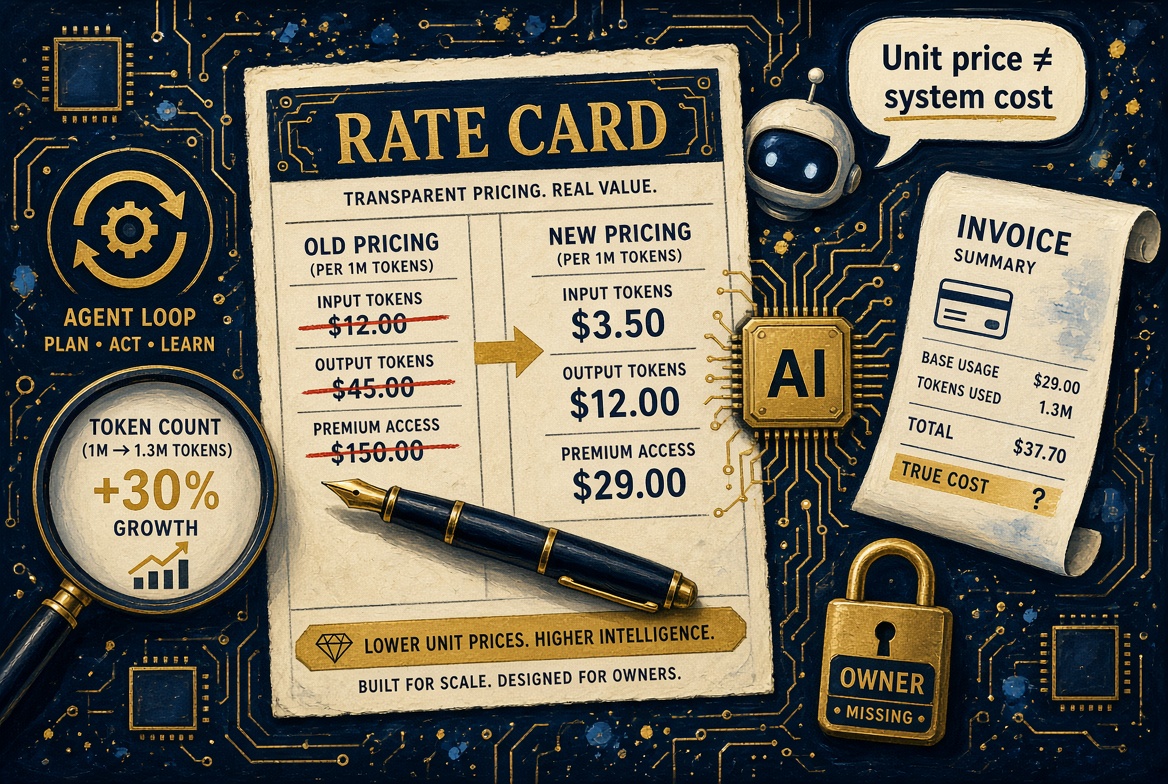
各大实验室会继续谈论“每美元智能”这个概念。这个说法很好地服务了它们关于效率的叙事,却是一个糟糕的管理指标。
每美元智能这个指标,不会告诉你某项任务究竟应该交给前沿模型、主力模型、分类器来处理,还是根本不需要模型;它不会告诉你输出结果是否经过审核;它不会告诉你智能体是否获得了调用写入类工具的权限;它也不会告诉你,上个月的账单是否对应着一个如今依然存在的流程。
人工智能的成本纪律,更接近于 FinOps,而非采购管理。你需要一份在用模型的清单、每一类任务的默认路由规则、对智能体循环次数的上限、能把 Token 消耗与具体团队和工作流关联起来的日志记录,以及一条规则:在错误答案的代价大于节省下来的成本时,明确禁止使用更便宜的模型。
这比把默认下拉菜单切换到 Luna 要慢得多,但也是唯一能让一次降价真正转化为节省、而不是用量暴增的方法。
DNLA 模型成本控制行动手册
- 把单价和工作流成本区分开来。衡量的标准应当是每一个已完成、已审核成果所花费的金额,而不是每百万 Token 的价格。
- 为每一条生产环境中的模型调用路径指定负责人:谁能够开启它,谁来为它付费,谁能够关闭它。
- 按任务类别进行路由。分类、信息提取、初稿撰写和高风险建议,不应共用同一个默认模型。
- 为智能体的循环和重试设置上限。一个可以无限制调用工具的廉价模型,就是一张不设上限的账单。
- 按团队、系统和供应商记录 Token 消耗日志。如果财务部门无法看清从账单到具体流程的路径,就谈不上真正的掌控。
- 按照公开的标准价格制定预算,把任何促销折扣都当作额外收益来记账。每当更换模型版本时,都要重新测算 Token 用量。
- 每当主力模型档位发生变化时,重新计算“自建还是购买”的这笔账。一次降价,既可能是继续留在某个供应商体系内的合理理由,也可能掩盖了这样一个事实:这套系统始终未能证明自己的价值。
DNLA 观点
7月下旬到8月中旬这一轮廉价模型浪潮,检验的是企业究竟有没有一套人工智能成本管理体系,财务委员会理应把它当作一次考验来对待。
更低的标价,会让启动更多工作变得更容易,也会让人更难注意到:这些工作既没有负责人,也没有上限,更没有被衡量的结果。那些已经按流程追踪用量的企业,会把这次降价转化为利润;而那些只盯着价目表的企业,则会把它转化为一张更大、也更悄无声息的账单。
更便宜的 Token 本身并不是成本纪律。真正的成本纪律,是清楚知道哪些调用是被允许的、哪个模型有权发起这些调用,以及当账单与商业论证不再吻合时,接下来会发生什么。
想让同样严谨的方法应用到你自己的人工智能系统上吗?
这正是 QAi 健康检查存在的意义。